Tout dépend de la tâche. Aux tests indépendants, Claude Fable 5.2 d'Anthropic fait mieux que GPT-6.2 Astra d'OpenAI, 65 contre 62, au même prix affiché de 8 $ et 40 $ par million de tokens, et coûte 6,6 fois plus par tâche. Claude Opus 5.5 devance GPT-6.2 Sol en stratégie, en finance et sur le code à fusionner, et Sol l'emporte en automatisation et en CAO pour environ un dixième du coût. OpenAI a sorti Astra et Sol le 17 novembre 2026, huit jours après Fable 5.2. Au programme : ce qu'OpenAI a annoncé, comment les deux paires se comparent sur le coût et sur le travail réel, pourquoi les deux produits se ressemblent de plus en plus, et comment une entreprise peut choisir sans changer d'outil à chaque lancement. Prix et scores au 18 novembre 2026.
L'essentiel
- GPT-6.2 Astra et Sol tournent dans ChatGPT Work et Codex sur les forfaits Plus, Pro, Business, Enterprise et Edu, et dans l'API. Aucun des deux n'est dans le chat ChatGPT classique.
- Astra et Claude Fable 5.2 affichent le même prix, 8 $ et 40 $ par million de tokens. Sur les mesures d'Artificial Analysis, Fable obtient 65 contre 62 pour Astra et coûte 6,6 fois plus par tâche à effort maximal.
- GPT-6.2 Sol face à Claude Opus 5.5 : Opus mène en stratégie, finance, livrables de bureau et code à fusionner. Sol mène en automatisation et en CAO, pour environ un dixième du coût par tâche.
- Les premiers testeurs ont trouvé Astra inégal et difficile à piloter, et ont salué son travail en 3D. Les scores de code indépendants n'ont pas bougé.
- Les licences d'équipe coûtent la même chose des deux côtés : 25 $ par mois, ou 20 $ en annuel.
- Les fonctions convergent, jusqu'au menu Customize de Claude rebaptisé Plugins. Choisissez selon votre mix de travail et vos règles sur les données, puis testez sur vos propres tâches.
« Est-ce qu'on a le bon outil ? »
Si vous pilotez l'adoption de l'IA dans une entreprise, le message est sans doute arrivé cette semaine. Un lien vers l'annonce d'OpenAI, transféré par quelqu'un de haut placé, avec une ligne au-dessus : est-ce qu'on a le bon outil ?
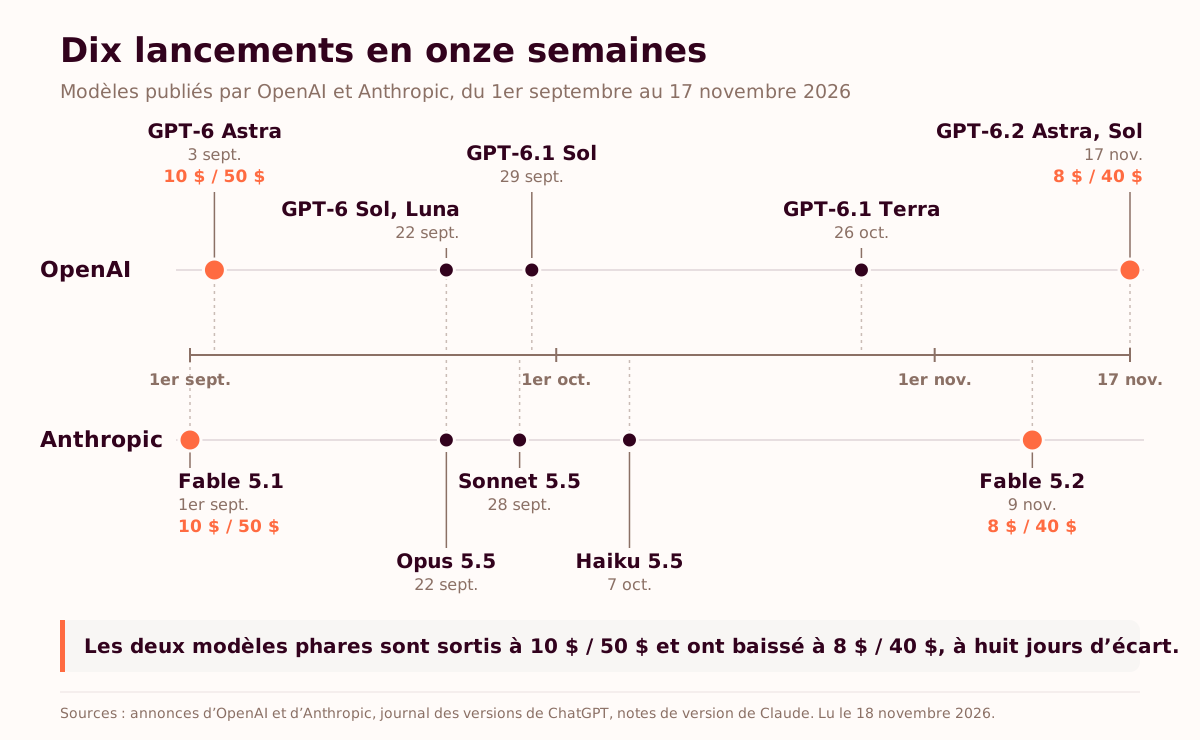
La question est légitime, et elle revient sans cesse. OpenAI et Anthropic ont sorti dix modèles entre le 1er septembre et le 17 novembre 2026, et la plupart des annonces étaient accompagnées d'un graphique où le nouveau modèle trône en haut.
Ce lancement mérite une lecture attentive pour une raison précise. Pour la première fois, les deux modèles phares affichent exactement le même prix. La comparaison devient nette, et elle montre le peu que dit une grille tarifaire.
Qu'a annoncé OpenAI le 17 novembre 2026 ?
OpenAI a annoncé deux modèles le 17 novembre 2026 : GPT-6.2 Astra, « notre nouveau modèle de pointe pour vos projets les plus difficiles », et GPT-6.2 Sol, « notre modèle efficace et polyvalent pour le travail du quotidien » (OpenAI). Les deux tournent dans ChatGPT Work et Codex, et dans l'API sous les noms gpt-6.2-astra et gpt-6.2-sol.
- Pour qui : les forfaits Plus, Pro, Business, Enterprise et Edu. Sur Enterprise et Edu, l'administrateur doit d'abord activer les modèles (ChatGPT Learn).
- Où ils ne tournent pas : le chat ChatGPT classique. « Pour utiliser GPT-6.2 Astra ou Sol dans ChatGPT, ouvrez Work », indique le guide d'OpenAI.
- Par défaut : les nouvelles conversations Work s'ouvrent sur Sol, en effort de raisonnement léger sur les forfaits grand public et moyen sur Enterprise.
- Le prix : Astra baisse de 20 %, à 8 $ par million de tokens en entrée et 40 $ en sortie. Sol garde les 2 $ et 10 $ de GPT-6.1 Sol (OpenAI).
- La vitesse : un mode Ultrafast sur les deux modèles dans l'API. Dans ChatGPT, les abonnés Pro 500 l'ont sur les deux modèles, les abonnés Pro 200 sur Sol.
Le calendrier dit l'essentiel. Claude Fable 5.2 est sorti le 9 novembre au même prix de 8 $ et 40 $, et Google a ouvert Gemini 4 Carbon au public le 10 novembre (VentureBeat). Pour le modèle phare précédent d'OpenAI, notre guide GPT-6 Astra au travail explique comment les équipes non techniques en tirent un résultat utile.
Qu'est-ce qui est censé être meilleur dans GPT-6.2 Astra et Sol ?
OpenAI met en avant l'efficacité : de meilleurs résultats sur les tâches exigeantes avec moins de tokens en sortie, pour que le même forfait ou le même budget aille plus loin. Astra est vendu sur les livrables professionnels, le code, la 3D et le pilotage de l'ordinateur. Sol est présenté comme le modèle qui boucle plus de tâches avec le même abonnement.
| Ce qu'OpenAI annonce | La preuve d'OpenAI |
|---|---|
| Le même travail avec moins de tokens | GDPval v2, de longues missions tirées de vrais projets en conseil, finance et design : Astra gagne 6,2 points sur GPT-6 Astra avec 22 % de tokens de sortie en moins |
| Des présentations, classeurs et documents fidèles à votre modèle | Des slides refaites à partir d'une capture d'écran « jusqu'à la taille exacte de la police ». Sur le benchmark juridique de Harvey : 15,0 % de réussite stricte, contre 8,6 % pour GPT-6 Astra |
| De meilleurs sites, de la 3D et de la CAO | AA-3D, un vote humain à l'aveugle : Astra 1 318 Elo, Claude Fable 5.2 1 271, Sol 1 259. BenchCAD 2.1 : 82,5 % contre 62,6 % pour GPT-6 Astra |
| Un pilotage de l'ordinateur plus précis | Des démonstrations dans des outils de CAO et de simulation, dont la suspension d'une voiture modélisée en Python et animée dans Blender |
| Sol en fait plus par abonnement | « Vous permet d'accomplir plus de tâches avec le même forfait payant. » À 0,5 point d'Astra sur FrontierCode 2.0, pour environ un cinquième du coût |
| Moins cher que Claude par tâche | Agents' Last Exam : Astra « 5,5 points devant Claude Fable 5.2 pour seulement 5 % du coût » |
Affirmations et chiffres tirés de l'annonce d'OpenAI du 17 novembre 2026. Tous viennent des tests d'OpenAI, sauf AA-3D, qu'Artificial Analysis mène avec des juges humains. Taux de réussite Harvey via VentureBeat.
Ce que disent les chiffres indépendants
Artificial Analysis, qui fait passer les mêmes tests à tous les modèles et publie sa méthode, classe GPT-6.2 Astra deuxième de son Intelligence Index avec 62, derrière Claude Fable 5.2 à 65. GPT-6.2 Sol obtient 57 (Artificial Analysis).
Le code n'a pas bougé. Sur le Coding Agent Index d'Artificial Analysis, Astra stagne face à GPT-6 Astra et Sol perd 3 points face à GPT-6.1 Sol, surtout parce qu'il omet plus souvent des faits importants quand il répond à des questions sur une base de code.
Astra mène en 3D interactive et sur un test préliminaire de robotique, et les modèles d'OpenAI occupent désormais l'essentiel de la frontière du coût par tâche. Astra invente aussi. Quand il ne connaît pas une réponse factuelle, il en fabrique une 59 % du temps à effort maximal, et Sol 55 % du temps, sur le test AA-Omniscience (Artificial Analysis).
Ce que disent les premiers testeurs
L'accueil a été rude. Matt Shumer, ancien patron de HyperWrite, a jugé les modèles « pratiquement inutilisables » pour le travail délégué. Le développeur Theo Browne a qualifié Astra de « pire modèle jamais sorti par OpenAI ». Ethan Mollick l'a trouvé « très inégal et bizarre », et plus difficile à piloter que les modèles concurrents (VentureBeat, Mollick sur X).
Shumer a confié du travail à Astra en sous-agent, sous la supervision de modèles Claude, et les modèles Claude l'ont refait. Chez Every, l'équipe de Dan Shipper a testé les deux modèles pendant des semaines : Astra égale son prédécesseur sur la plupart de leurs tests de code, s'arrête souvent trop tôt sur les projets de bout en bout, et écrit trop court pour être suivi. « Personne dans l'équipe ne l'a adoré », a résumé Shipper (Every).
Les mêmes testeurs ont salué le travail en 3D, les prototypes de jeux, le motion design et le pilotage de l'ordinateur. Browne reconnaît qu'Astra a repéré en revue de code des problèmes que d'autres modèles avaient manqués, et il préfère toujours Claude Opus 5.5 pour son propre développement. Les avis du jour de lancement viennent de testeurs précis sur des tâches précises, et ceux-là se contredisent.
La fiche système d'OpenAI ajoute un constat à connaître avant de confier un travail d'agent à Astra. Les deux modèles signalent moins souvent un obstacle qui a bloqué la tâche, comme un fichier manquant. Sans les instructions qu'OpenAI livre dans Codex, Astra a passé l'obstacle sous silence dans 22,28 % des cas, le double des 11,09 % de GPT-6 Astra (fiche système de GPT-6.2).
GPT-6.2 Astra face à Claude Fable 5.2 : que donne la comparaison ?
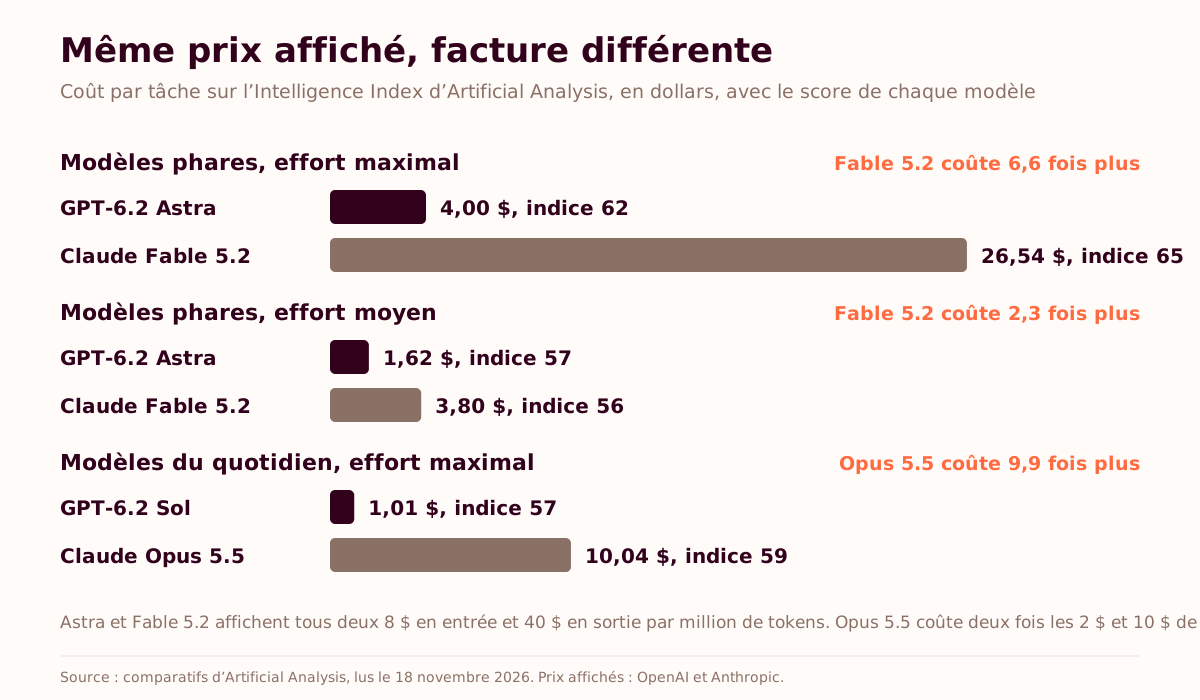
GPT-6.2 Astra et Claude Fable 5.2 affichent le même prix par token. Fable obtient de meilleurs scores aux tests indépendants et coûte plusieurs fois plus cher par tâche. Sur l'Intelligence Index d'Artificial Analysis, Fable 5.2 obtient 65 et Astra 62 à effort maximal, pour 26,54 $ et 4,00 $ par tâche (Artificial Analysis).
Prix et accès
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| Éditeur, sortie | OpenAI, 17 novembre 2026 | Anthropic, 9 novembre 2026 |
| L'usage annoncé | « Vos projets les plus difficiles » | « Le travail technique le plus ambitieux et le plus ouvert ». Anthropic conseille de commencer par Opus 5.5 |
| Prix API, par million de tokens | 8 $ en entrée, 40 $ en sortie | 8 $ en entrée, 40 $ en sortie |
| Entrée en cache, par million | 0,40 $ | 0,20 $ |
| Requêtes de plus de 272 000 tokens | Toute la requête à 16 $ et 60 $ | Tarif standard sur toute la fenêtre de 1 million |
| Modes rapides | Fast au double du prix. Ultrafast au triple jusqu'au 28 février 2027, puis à six fois | Mode rapide à 16 $ et 80 $, jusqu'à 2,5 fois plus vite |
| Traitement par lots | 50 % de remise | 50 % de remise |
| Fenêtre de contexte, réponse la plus longue | 1,05 million de tokens, 128 000 | 1 million de tokens, 128 000 |
| Accès le moins cher | ChatGPT Plus, 20 $ par mois, dans Work et Codex seulement | Claude Pro, 20 $ par mois, avec des crédits d'usage. Inclus dès Max, 100 $ par mois, jusqu'à la moitié de la limite hebdomadaire |
| Licence d'équipe qui l'inclut | ChatGPT Business, 25 $ par mois ou 20 $ en annuel | Licence Team premium, 125 $ par mois ou 100 $ en annuel, jusqu'à la moitié de la limite hebdomadaire |
| Enterprise | Sur devis. L'administrateur active GPT-6.2 | 20 $ par licence et par mois, plus l'usage au tarif API, 20 licences minimum |
| Données | Hébergement aux États-Unis ou dans l'UE en Standard, Fast et lots. Ultrafast aux États-Unis seulement | Conservation 30 jours pour la surveillance de sécurité, sauf éligibilité à la zéro rétention des données |
Prix tirés de l'annonce d'OpenAI, de ChatGPT Learn, de l'annonce d'Anthropic et de claude.com/pricing. Règles sur les longues requêtes et le cache d'après VentureBeat et la lecture des deux grilles par AlphaCorp AI. Prix des licences d'après le centre d'aide d'OpenAI. Lu le 18 novembre 2026.
Résultats sur des tâches de travail
| Test | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Mesuré par Artificial Analysis, effort maximal sauf mention contraire | ||
| Intelligence Index (neuf tests) | 62 | 65 |
| Coût par tâche de l'index, effort maximal | 4,00 $ | 26,54 $ |
| Coût par tâche de l'index, effort moyen | 1,62 $ | 3,80 $ |
| Temps par tâche de l'index, effort maximal | 10,4 minutes | 40,8 minutes |
| Score finance et comptabilité | 61 | 65 |
| Score stratégie et opérations | 63 | 67 |
| Score juridique | 59 | 63 |
| Livrables de bureau (AA-Briefcase, Elo) | 1 643 | 1 785 |
| Connaissances factuelles (AA-Omniscience) | 50 | 67 |
| Automatisation métier (AutomationBench) | 77,2 % | 76,4 % |
| Code que des mainteneurs fusionneraient (FrontierCode 2.0) | 45,4 % | 48,8 % |
| Code dans un terminal (Terminal-Bench 4.0) | 64,1 % | 59,6 % |
| Recherche dans un terminal (Terminal-Bench-Science) | 78,1 % | 73,3 % |
| 3D interactive, vote humain à l'aveugle (AA-3D, Elo) | 1 318 | 1 271 |
| Mesuré par OpenAI | ||
| Longs processus professionnels (Agents' Last Exam) | 78,3 % à 2,89 $ la tâche | 72,8 % à 60,05 $ la tâche, effort maximal seulement, neuf tâches exclues |
| Livrables juridiques, réussite stricte (Harvey LAB-AA) | 15,0 % | 7,2 % |
| Missions professionnelles (GDPval v2) | 50,4 %, 35 812 tokens de sortie par tâche | 44,8 %, 222 344 tokens de sortie par tâche |
Lignes indépendantes tirées de la page de comparaison d'Artificial Analysis et de son analyse du lancement. Lignes mesurées par OpenAI tirées de ses graphiques de lancement, avec les chiffres de Claude relevés sur ces graphiques par AlphaCorp AI. OpenAI n'a tracé Fable 5.2 sur Agents' Last Exam qu'à effort maximal.
Trois choses que les tableaux ne disent pas seuls
Même prix affiché, facture différente. Astra et Fable 5.2 facturent tous deux 8 $ et 40 $. Sur les mêmes neuf tests, Fable a consommé assez de tokens supplémentaires pour coûter 6,6 fois plus par tâche à effort maximal, et 2,3 fois plus à effort moyen, le réglage par défaut des applis Claude. Sur GDPval v2 mesuré par OpenAI, Fable a écrit 222 344 tokens de sortie par tâche contre 35 812 pour Astra. L'effort maximal n'est pas toujours le meilleur réglage non plus : sur le graphique FrontierCode d'OpenAI, Fable 5.2 obtient 49,1 % en Xhigh et 45,6 % en Max, qui coûte environ trois fois plus (AlphaCorp AI).
Regardez qui a fait passer le test. Les graphiques de lancement d'OpenAI sont les mesures d'OpenAI sur Claude. Le tableau d'Anthropic du 9 novembre compare Fable 5.2 à GPT-6 Astra, l'ancien modèle (Anthropic). Les lignes indépendantes viennent d'Artificial Analysis. Quand un chiffre figure sur les pages des deux éditeurs, il concorde : Fable 5.2 à 49,1 % sur FrontierCode 2.0, et Opus 5.5 à 65,3 % sur BenchCAD.
Les longues requêtes changent le calcul. Au-delà de 272 000 tokens en entrée, OpenAI facture toute la requête Astra à 16 $ et 60 $ par million. Anthropic garde Fable 5.2 au tarif standard sur toute la fenêtre de 1 million (AlphaCorp AI). Pour une équipe qui envoie des dossiers de contrats ou des bases de code entières en une requête, cette règle peut peser plus que toutes les autres lignes.
Pour Fable 5.2 dans Claude, Cowork et Claude Code, avec ce que comprend chaque forfait, voir notre guide de Claude Fable 5.2 pour les entreprises.
Combien coûtent GPT-6.2 et Claude à une entreprise ?
Sur les licences, rien ne les sépare. ChatGPT Business et Claude Team facturent tous deux 25 $ par licence et par mois, ou 20 $ en annuel, et 125 $ ou 100 $ pour une licence premium (OpenAI, Anthropic). La différence se joue sur les modèles accessibles avec chaque licence, et sur la vitesse à laquelle elle s'épuise.
| Forfait | ChatGPT | Claude |
|---|---|---|
| Une personne | Plus, 20 $ par mois | Pro, 20 $ par mois, ou 17 $ en annuel |
| Un gros utilisateur | Pro, 100 $, 200 $ ou 500 $ par mois | Max, 100 $ par mois, ou Ultra, 200 $ |
| Licence d'équipe | Business Standard, 25 $ par mois ou 20 $ en annuel, de 2 à 200 licences | Team Standard, 25 $ par mois ou 20 $ en annuel, de 2 à 150 licences |
| Licence d'équipe premium | Business Premium, 125 $ par mois ou 100 $ en annuel | Team Premium, 125 $ par mois ou 100 $ en annuel |
| Enterprise | Sur devis | 20 $ par licence plus l'usage au tarif API, 20 licences minimum |
| Le nouveau modèle phare | Astra et Sol dans Work et Codex, dès Plus | Fable 5.2 sur Max, Ultra et les licences Team premium, jusqu'à la moitié de la limite hebdomadaire. Crédits d'usage sur Pro |
Prix tirés de chatgpt.com/pricing, de la page des forfaits Pro d'OpenAI, de sa page de facturation Business et de claude.com/pricing, lus le 18 novembre 2026. Prix américains, hors taxes. Pour un guide d'achat forfait par forfait, voir les forfaits ChatGPT et Claude pour les entreprises.
Par tâche, l'écart est large. Sol coûte 1,01 $ par tâche de l'index d'Artificial Analysis à effort maximal, Opus 5.5 coûte 10,04 $. Astra coûte 4,00 $, Fable 5.2 coûte 26,54 $. Dans un abonnement, cela se voit à la vitesse à laquelle les équipes atteignent leurs limites. Dans l'API, cela se voit sur la facture.
Aucun de ces chiffres n'inclut le poste le plus cher : la personne qui relit le résultat et le renvoie. VentureBeat l'a écrit sans détour dans son compte rendu du lancement : ce qui compte, c'est le coût d'un résultat utilisable par l'entreprise, y compris les essais ratés et le temps qu'un analyste passe à corriger le fichier (VentureBeat). Une tâche bon marché qui revient deux fois est une tâche chère.
Le chiffre
Mettez vos propres chiffres.
Licences, heures gagnées, coût horaire. Le calculateur de ROI IA vous donne le chiffre que votre DAF demandera avant le renouvellement, hypothèses écrites noir sur blanc.
Lancer le calculateur de ROI IA →GPT-6.2 Sol face à Claude Opus 5.5 : lequel pour quel travail ?
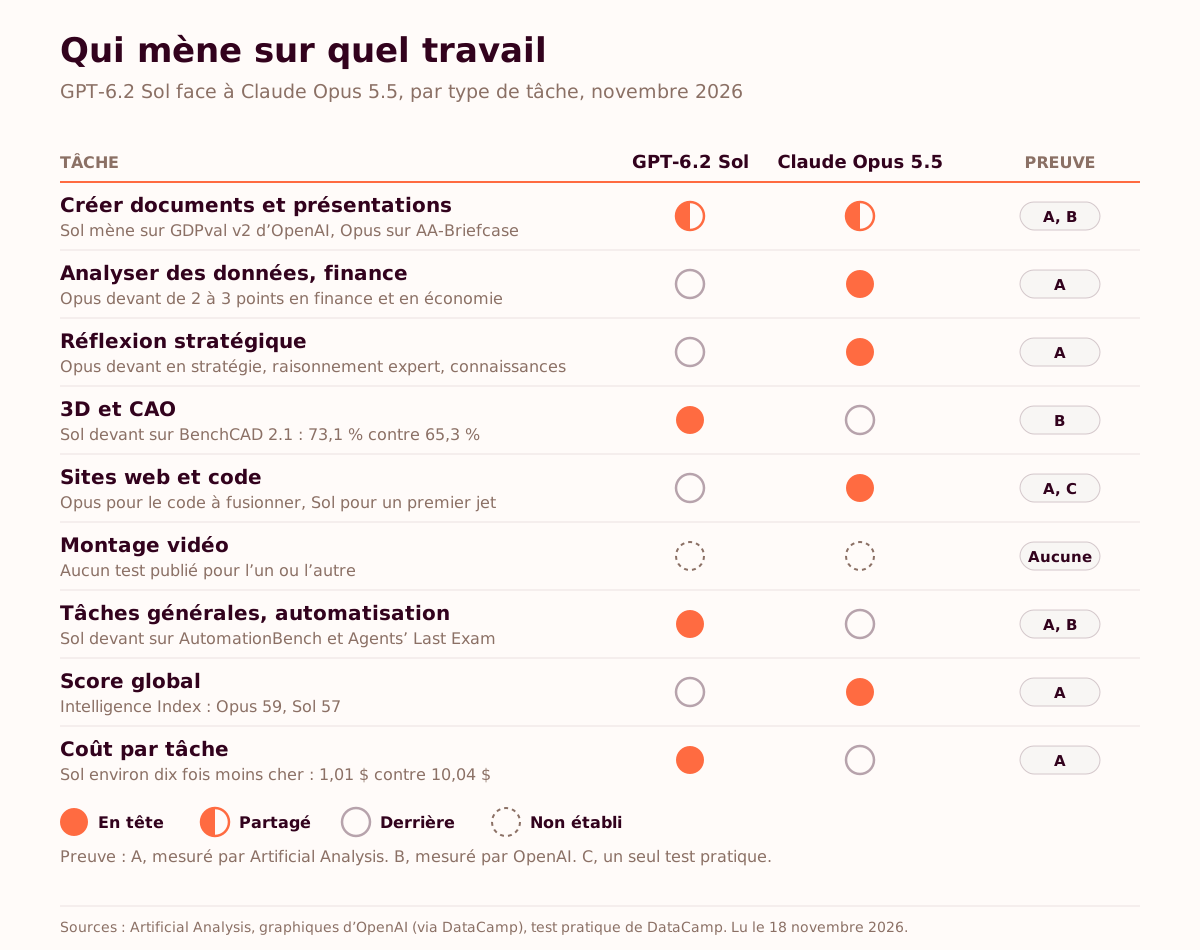
Claude Opus 5.5 devance GPT-6.2 Sol en stratégie, en finance, sur les livrables de bureau et sur le code à fusionner. Sol mène en automatisation métier et en CAO, et coûte environ dix fois moins par tâche. Sur l'Intelligence Index d'Artificial Analysis, Opus 5.5 obtient 59 et Sol 57 (Artificial Analysis).
Ce sont les deux modèles que la plupart des salariés vont réellement rencontrer. Sol est le modèle par défaut de ChatGPT Work. Anthropic présente Opus 5.5 comme son modèle de travail quotidien le plus solide et conseille de commencer par lui (Anthropic). Et non, il n'existe pas de Claude Opus 5.2 : le 5.2 appartient à Fable.
| Tâche | GPT-6.2 Sol | Claude Opus 5.5 | Qui mène, et avec quelle certitude |
|---|---|---|---|
| Créer documents, présentations et classeurs | GDPval v2 : 46,9 %. AA-Briefcase : 1 612 Elo | GDPval v2 : 43,5 %. AA-Briefcase : 1 800 Elo | Partagé. Sol sur le test d'OpenAI, Opus sur le test indépendant (A, B) |
| Analyser des données, finance | Finance et comptabilité : 57. Économie : 57 | Finance et comptabilité : 59. Économie : 60 | Opus, de 2 à 3 points (A) |
| Réflexion stratégique | Stratégie et opérations : 59. Raisonnement expert (HLE-Diamond) : 64,0 %. Connaissances factuelles : 40 | Stratégie et opérations : 61. Raisonnement expert : 67,9 %. Connaissances factuelles : 48 | Opus (A) |
| 3D et CAO | BenchCAD 2.1 : 73,1 %. AA-3D : 1 259 Elo | BenchCAD 2.1 : 65,3 % | Sol en CAO (B). Les deux éditeurs publient le même 65,3 % pour Opus |
| Sites web et code | FrontierCode 2.0 : 44,4 %. Coding Agent Index : 50, dans Codex | FrontierCode 2.0 : 46,4 %. Coding Agent Index : 58, dans Claude Code | Opus pour le code qui doit être juste (A). Un test de shader : Sol noté 4,8 sur 5 pour 0,21 $, Opus 4,5 pour 1,20 $ (C) |
| Montage vidéo | Aucun test publié | Aucun test publié | Non établi. Les testeurs ont salué Astra en motion design, et personne n'a testé Sol là-dessus (C) |
| Tâches générales, automatisation | AutomationBench : 71,3 %. Agents' Last Exam : 73,0 % à 1,32 $ la tâche | AutomationBench : 69,5 %. Agents' Last Exam : 71,6 % à 17,57 $ la tâche | Sol (A, B) |
| Global | Intelligence Index : 57 | Intelligence Index : 59 | Opus, de 2 points (A) |
| Coût par tâche de l'index, effort maximal | 1,01 $ | 10,04 $ | Sol, environ dix fois moins (A) |
| Temps par tâche de l'index, effort maximal | 7,9 minutes | 24,5 minutes | Sol (A) |
| Prix API, par million de tokens | 2 $ en entrée, 10 $ en sortie | 4 $ en entrée, 20 $ en sortie | Sol, à moitié prix (A) |
A : mesuré par Artificial Analysis. B : mesuré par OpenAI, d'après ses graphiques de lancement repris par DataCamp. C : un seul test pratique (DataCamp) ou des retours de testeurs (VentureBeat). Les chiffres du Coding Agent Index correspondent au meilleur réglage de chaque modèle. Lu le 18 novembre 2026.
En lisant le tableau tâche par tâche, deux tendances ressortent. Opus 5.5 mène là où Artificial Analysis note le raisonnement, les connaissances et les livrables de bureau finis, de 2 à 8 points. Sol mène quand le travail est une longue chaîne d'étapes entre applis métier, et sur le prix, d'un facteur dix.
La ligne du code est celle où l'écart est réel. Opus 5.5 dans Claude Code obtient 58 sur le Coding Agent Index et Sol dans Codex 50 (DataCamp). Dans l'unique test de shader de DataCamp, Sol a produit la scène la plus réaliste pour un sixième du prix. Le premier jet d'un site web et une modification que quelqu'un doit fusionner sont deux métiers différents.
Le montage vidéo est le vrai trou. Aucun benchmark ne teste l'un ou l'autre modèle sur ce terrain. Les éloges des premiers testeurs portent sur le motion design et le montage piloté par agent d'Astra (VentureBeat), et l'outil vidéo de Claude, Claude Motion, est en bêta sur Team et Enterprise (Anthropic). Pour les équipes sur Claude, notre formation Claude pour les équipes part du travail que chaque équipe fait déjà.
Pourquoi ChatGPT et Claude se ressemblent-ils un peu plus chaque mois ?
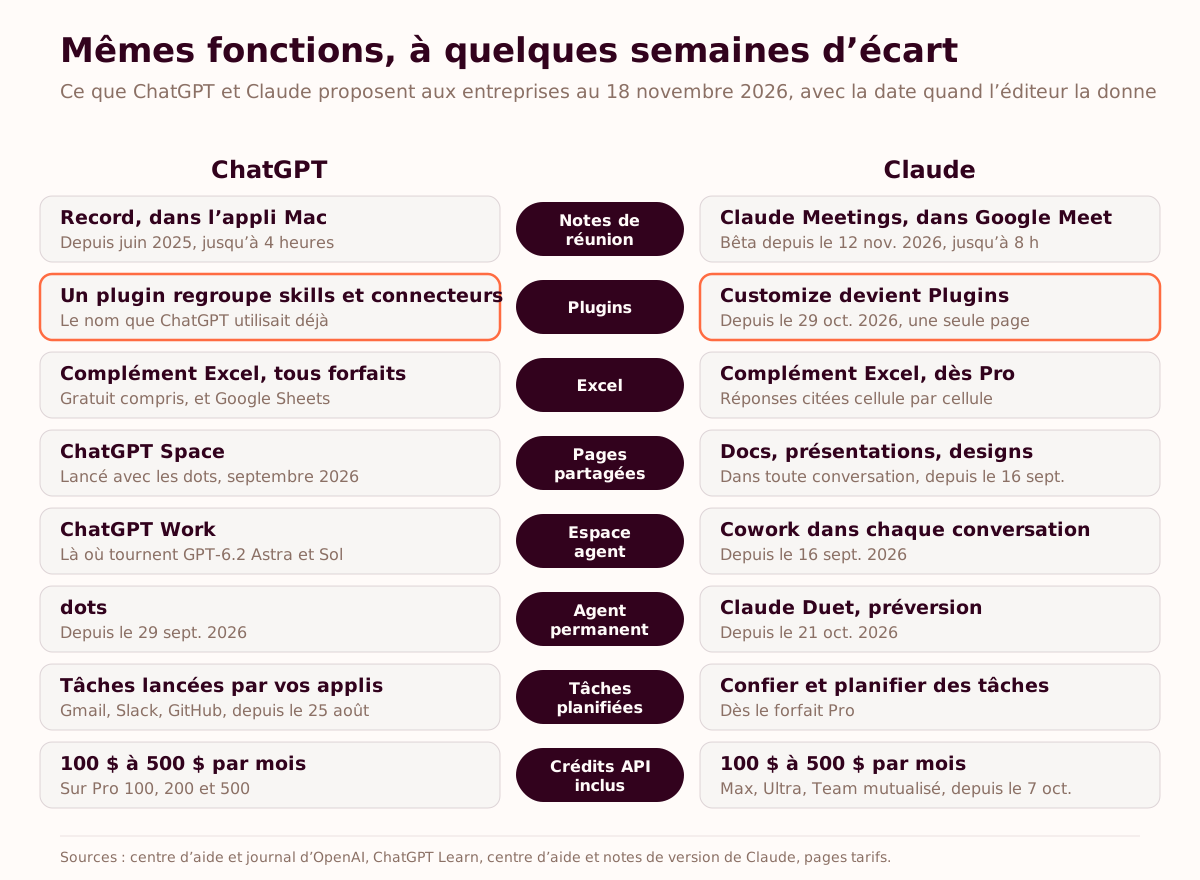
Parce que chacun livre ce que l'autre a déjà, quelques semaines ou quelques mois plus tard. Au 18 novembre 2026, les deux produits se recouvrent sur les notes de réunion, les plugins, les compléments Excel, les pages partagées, les espaces agents, les agents permanents, les tâches planifiées et les crédits API inclus. Une liste de fonctions n'est plus une raison de choisir.
| Fonction | ChatGPT | Claude |
|---|---|---|
| Notes de réunion | Record transcrit et résume les réunions dans l'appli Mac, depuis juin 2025. Il rejoint les appels Google Meet de votre agenda, jusqu'à 4 heures | Claude Meetings, en bêta sur Team et Enterprise depuis le 12 novembre 2026. Il rejoint Google Meet comme participant visible, jusqu'à 8 heures |
| Plugins | Un plugin regroupe des skills et des connecteurs (serveurs MCP) | Customize devient Plugins à partir du 29 octobre 2026 : une seule page pour les skills, les connecteurs et les plugins |
| Excel | Complément sur tous les forfaits, gratuit compris, et une version Google Sheets | Complément dès Pro, avec des réponses qui citent les cellules |
| Pages partagées | ChatGPT Space, lancé avec les dots en septembre 2026, remplace la bibliothèque | Designs, présentations et documents dans toute conversation depuis le 16 septembre 2026. Sheets et Whiteboards en bêta |
| Espace agent | ChatGPT Work | Cowork dans chaque conversation depuis le 16 septembre 2026 |
| Agent permanent | dots, depuis le 29 septembre 2026 | Claude Duet, en préversion depuis le 21 octobre 2026 |
| Tâches planifiées | Tâches lancées par des événements Gmail, Slack et GitHub, depuis le 25 août 2026 | Confier et planifier des tâches, dès le forfait Pro |
| Crédits API dans l'abonnement | 100 $ à 500 $ par mois sur les forfaits Pro | 100 $ sur Max, 200 $ sur Ultra, jusqu'à 500 $ mutualisés sur Team, depuis le 7 octobre 2026 |
Sources : centre d'aide d'OpenAI et OpenAI sur X pour Record, ChatGPT Learn pour les plugins, centre d'aide de Claude pour la page Plugins, notes de version de Claude, journal de ChatGPT, Chris Alarcon pour les compléments Excel, ChatGPT Space et eesel AI pour son lancement, OpenAI pour les dots, pages tarifs de chatgpt.com et claude.com. Lu le 18 novembre 2026.
Le changement de nom des plugins résume tout. Depuis le 29 octobre 2026, le menu que Claude appelait Customize s'intitule Plugins dans la barre latérale, le menu du chat et les réglages, et une seule page remplace les onglets Skills, Connectors et Plugins (centre d'aide de Claude). Plugins, c'est le mot que ChatGPT utilisait déjà. Dans la documentation d'OpenAI, un plugin est « un ensemble installable qui peut contenir des skills et des serveurs Model Context Protocol (MCP) » (ChatGPT Learn). Même mot, même assemblage, même menu.
Un détail pour les administrateurs : la nouvelle page devient la règle sur Enterprise le 30 novembre, et à partir de cette date une organisation Team ou Enterprise qui a désactivé les Skills bloque aussi les plugins dans Claude Desktop.
Pour les réunions, c'est l'inverse. Le mode Record de ChatGPT est arrivé dans l'appli Mac en juin 2025 (OpenAI sur X). Anthropic a annoncé Claude Meetings le 10 novembre 2026, un participant qui fait le travail pendant que la réunion se tient encore, et la bêta est déployée depuis le 12 novembre (Reuters, notes de version de Claude).
Même les testeurs se recoupent. Jump Trading, IMC et Harvey sont cités pour saluer le nouveau modèle sur la page de lancement d'Anthropic le 9 novembre, puis sur celle d'OpenAI le 17 novembre. Deux des citations viennent des mêmes personnes : Marquis Wong chez IMC et Niko Grupen chez Harvey (Anthropic, OpenAI). Et l'annonce d'Anthropic détourne elle-même la plupart du travail quotidien de son modèle phare : commencez par Claude Opus 5.5, conseille-t-elle.
Un comparatif de fonctions a donc une durée de vie d'environ un mois. Le nôtre compris. Pour les agents de chaque côté, voir notre comparatif des dots, de Claude Duet et des autres agents personnels, et côté ChatGPT, ce que fait ChatGPT Enterprise au-delà des e-mails.
Gratuit, 8 minutes
Avant de changer de modèle, regardez ce que vos équipes font de celui qu'elles ont.
L'audit de maturité IA situe votre entreprise sur le modèle de maturité IA WCS en 21 questions.
Vous obtenez votre stade, le frein qui vous retient (personnes, direction, processus ou fondations) et le processus à corriger en premier. Rapport personnalisé gratuit, sans carte bancaire.
Lancer l'audit de maturité IA gratuit →Comment une entreprise doit-elle choisir entre ChatGPT et Claude ?
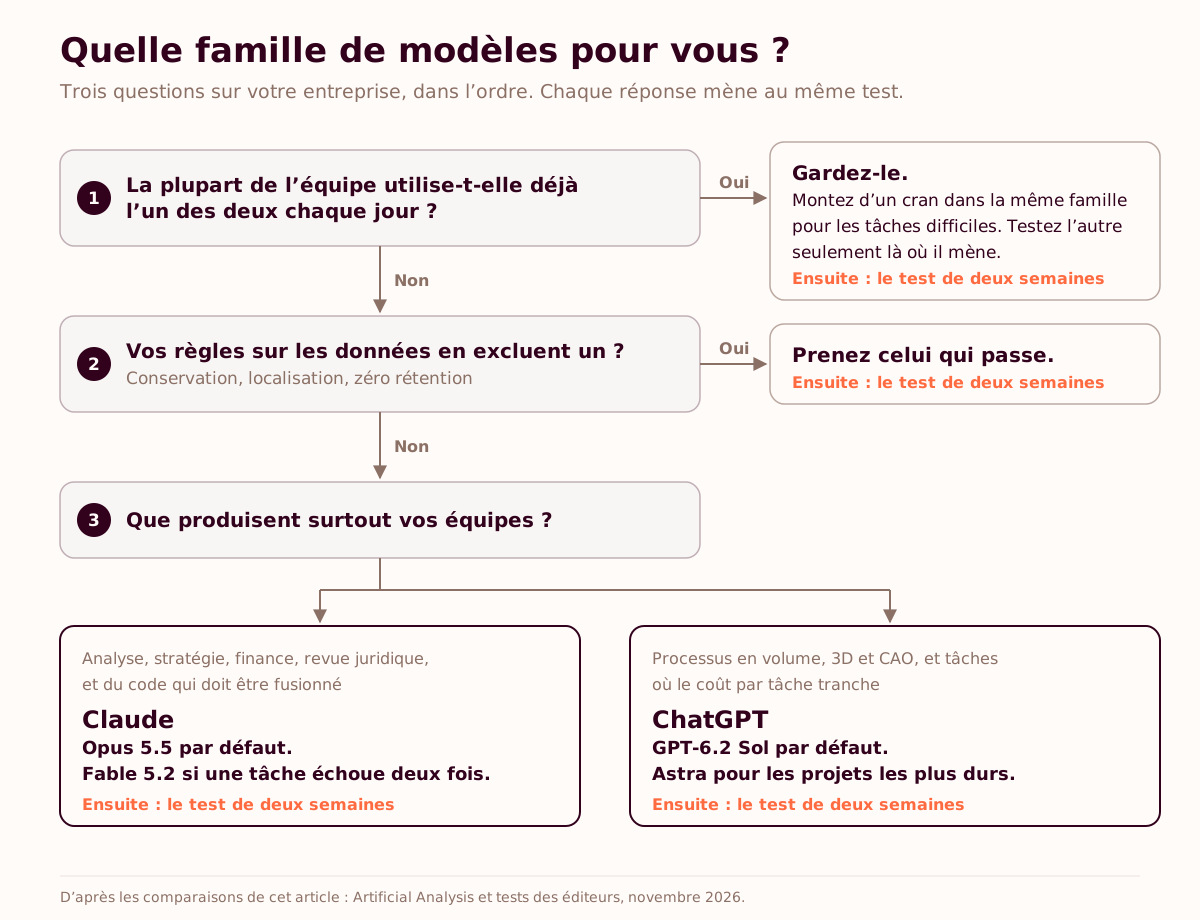
Choisissez selon ce que fait votre entreprise, puis testez sur votre propre travail. Le modèle changera encore avant votre prochain renouvellement. Votre mix de travail, vos règles sur les données et l'outil que vos équipes ouvrent chaque matin seront toujours là.
Voici les sept questions par lesquelles nous commençons. Aucune ne demande de benchmark.
| N° | Critère | La question | Où trouver la réponse |
|---|---|---|---|
| 1 | Le mix de travail | Que produisent vos équipes toute la semaine : présentations et notes, analyses, code, 3D ? | Le tableau par tâche ci-dessus, puis votre propre liste de tâches |
| 2 | Là où vit le travail | Microsoft 365, Google Workspace, Slack ? Quels compléments votre DSI autorise-t-elle déjà ? | Le tableau des fonctions, puis votre politique informatique |
| 3 | Le coût d'une tâche terminée | Combien coûte un résultat utilisable, relecture comprise ? | Le coût par tâche ci-dessus, puis votre propre relevé |
| 4 | Les règles sur les données | Conservation, localisation, zéro rétention, données de santé ? | La ligne données du premier tableau, puis votre DPO |
| 5 | Administration et contrôle | SSO, SCIM, journaux d'audit, et qui valide un plugin ? | Les pages Team et Enterprise de chaque éditeur |
| 6 | Le taux de retour | Combien de fois renvoie-t-on le résultat pour reprise ? | Votre propre relevé. Les testeurs de la semaine de lancement ne sont pas d'accord |
| 7 | Ce que font les équipes aujourd'hui | Combien de licences servent chaque semaine, et à quoi ? | Votre tableau de bord d'administration, ou l'audit ci-dessous |
Les deux premières tranchent la plupart des cas. Une équipe qui fait des présentations toute la journée et une équipe qui livre du code peuvent arriver à des réponses différentes dans la même entreprise, et un parc mixte est un résultat légitime. Pour la question des données, notre comparatif de la zéro rétention chez OpenAI, Claude, Gemini et Copilot détaille ce que propose chaque éditeur.
Le test de deux semaines
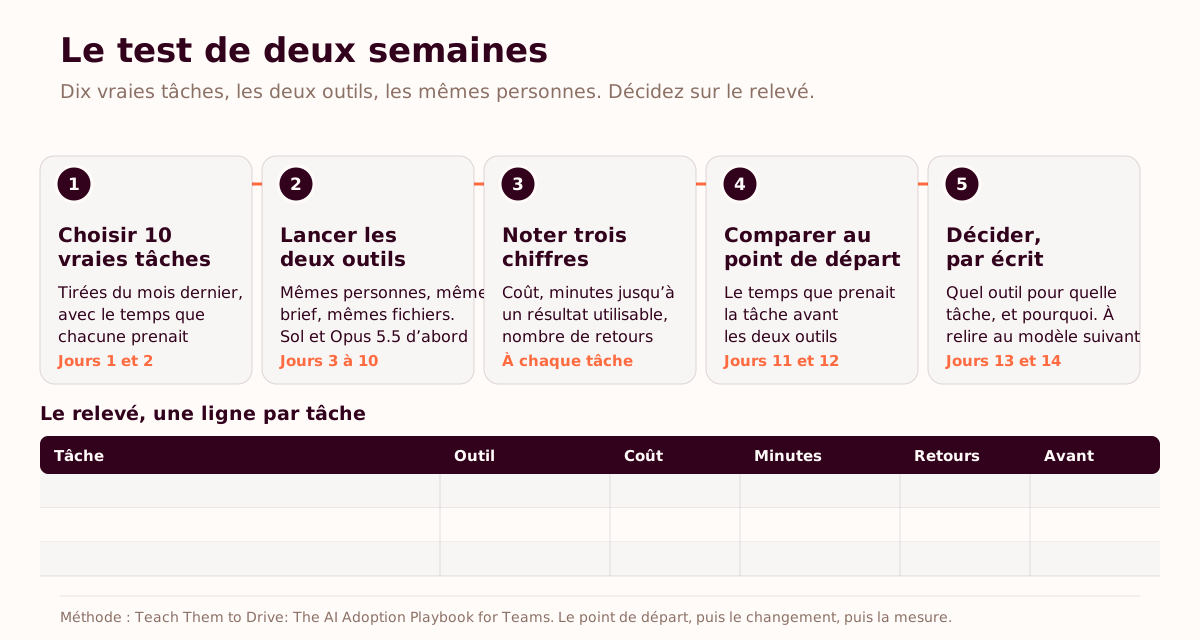
C'est le test que nous ferions avant de signer l'un ou l'autre contrat. Il prend deux semaines et les personnes qui font le travail.
- Choisissez 10 vraies tâches. Tirées du travail du mois dernier, avec le temps que chacune a pris. Une présentation pour le comité de direction, une synthèse de contrat, une mise à jour de prévisions, une comparaison de fournisseurs.
- Lancez les deux outils sur les mêmes tâches. Mêmes personnes, même brief, mêmes fichiers. Sol et Opus 5.5 d'abord. Astra et Fable 5.2 seulement pour les tâches qui échouent.
- Notez trois chiffres par tâche. Le coût, les minutes jusqu'à un résultat utilisable, et le nombre de fois où quelqu'un l'a renvoyé.
- Comparez au point de départ. Le temps que prenait chaque tâche avant que l'un ou l'autre outil y touche.
- Décidez, et écrivez pourquoi. Quel outil, pour quelle tâche. Cette note est ce que vous relirez à la sortie du prochain modèle.
Le modèle aura encore changé avant votre renouvellement
Un nouveau modèle est sorti cette semaine. Un autre sortira le mois prochain, avec un graphique qui le place en haut. La décision qui tient est celle prise sur vos propres tâches, avec un point de départ mesuré avant que quoi que ce soit change.
Nous avons décrit le même phénomène en septembre, quand quatre éditeurs ont publié la même semaine : la fatigue des modèles IA en entreprise. Deux mois et huit lancements plus tard, seuls les numéros de version ont changé. Et si vous envisagez de basculer complètement, migrer de Claude vers ChatGPT détaille le travail que cela demande.
« L'outil n'a jamais été le problème. Personne ne leur a appris à conduire. »
Toni Dos Santos, Teach Them to Drive: The AI Adoption Playbook for Teams
Le manuel
L'outil n'a jamais été le problème. Personne ne leur a appris à conduire.
Teach Them to Drive: The AI Adoption Playbook for Teams est la méthode derrière le test ci-dessus : un processus pénible, un point de départ mesuré avant tout changement, une répartition écrite entre ce que fait l'IA et ce que vérifie une personne, et une mesure à 30, 60 et 90 jours. Écrit pour les entreprises qui ont acheté les licences et dont les équipes s'en servent encore pour corriger des fautes. En anglais.
Découvrir le livre →Questions fréquentes
Que sont GPT-6.2 Astra et GPT-6.2 Sol ?
GPT-6.2 Astra et GPT-6.2 Sol sont des modèles d'OpenAI sortis le 17 novembre 2026. Astra est le modèle de pointe pour les projets les plus difficiles, à 8 $ par million de tokens en entrée et 40 $ en sortie. Sol est le modèle du quotidien, moins cher, à 2 $ et 10 $. Les deux tournent dans ChatGPT Work et Codex sur les forfaits Plus, Pro, Business, Enterprise et Edu, et dans l'API d'OpenAI.
Quelle différence entre GPT-6.2 et Claude ?
GPT-6.2 est la famille de modèles d'OpenAI sortie le 17 novembre 2026 : Astra pour les projets les plus difficiles et Sol pour le quotidien, dans ChatGPT Work, Codex et l'API. Claude est celle d'Anthropic : Fable 5.2 pour le travail le plus exigeant et Opus 5.5 comme modèle de tous les jours. Aux tests indépendants, Claude obtient de meilleurs scores en raisonnement, finance, juridique et sur le code à fusionner, tandis que GPT-6.2 coûte moins cher par tâche et mène en automatisation métier et en 3D interactive. Les modèles phares affichent le même prix, 8 $ et 40 $ par million de tokens, et la licence d'équipe coûte 25 $ par mois des deux côtés.
GPT-6.2 Astra est-il meilleur que Claude Fable 5.2 ?
Sur le score global indépendant, Claude Fable 5.2 est devant : 65 contre 62 sur l'Intelligence Index d'Artificial Analysis, avec une avance en finance, stratégie, juridique, connaissances factuelles et code. GPT-6.2 Astra mène en 3D interactive, en automatisation métier et sur le travail dans un terminal, et coûte environ six fois moins par tâche à effort maximal. Sur les graphiques de lancement d'OpenAI, Astra arrive devant sur six tests sur neuf.
GPT-6.2 Sol est-il meilleur que Claude Opus 5.5 ?
Cela dépend de la tâche. Claude Opus 5.5 obtient 59 contre 57 pour GPT-6.2 Sol sur l'Intelligence Index d'Artificial Analysis, et mène en stratégie, finance, livrables de bureau et agents de code. GPT-6.2 Sol mène en automatisation métier et en CAO, coûte deux fois moins par token et environ dix fois moins par tâche.
Combien coûtent GPT-6.2 Astra et Claude Fable 5.2 ?
Les deux affichent 8 $ par million de tokens en entrée et 40 $ en sortie en novembre 2026. L'entrée en cache coûte 0,40 $ sur Astra et 0,20 $ sur Fable 5.2, et Astra facture 16 $ et 60 $ au-delà de 272 000 tokens en entrée. Dans les applis, Astra est inclus dans ChatGPT Plus à 20 $ par mois dans Work et Codex, et Fable 5.2 dans Claude Max à 100 $ par mois, jusqu'à la moitié de la limite hebdomadaire.
Quel modèle choisir pour les tableurs, les présentations et les documents ?
Les preuves sont partagées. Sur GDPval v2 d'OpenAI, GPT-6.2 Sol obtient 46,9 % contre 43,5 % pour Claude Opus 5.5, et OpenAI a entraîné Astra à suivre les modèles de slides et de tableurs. Sur AA-Briefcase, le test de livrables de bureau d'Artificial Analysis, Claude mène : Opus 5.5 à 1 800 Elo et Fable 5.2 à 1 785, contre 1 643 pour Astra et 1 612 pour Sol. Un test sur vos propres modèles de documents tranche la question.
Peut-on utiliser GPT-6.2 dans ChatGPT classique ?
Non. Au 18 novembre 2026, GPT-6.2 Astra et Sol ne sont disponibles que dans ChatGPT Work et Codex, et le guide d'OpenAI indique d'ouvrir Work pour les utiliser. Sur Enterprise et Edu, un administrateur doit d'abord les activer dans les réglages de l'espace de travail.
Existe-t-il un Claude Opus 5.2 ?
Non. L'Opus actuel d'Anthropic est Claude Opus 5.5, sorti le 22 septembre 2026. Le numéro 5.2 appartient à Claude Fable 5.2 et Claude Mythos 5.2, sortis le 9 novembre 2026. Les comparaisons avec GPT-6.2 Sol utilisent Opus 5.5.
Faut-il changer de modèle à chaque nouvelle sortie ?
Seulement si un test sur vos propres tâches le justifie. OpenAI et Anthropic ont sorti dix modèles entre le 1er septembre et le 17 novembre 2026. Un essai de deux semaines sur dix vraies tâches, en notant le coût, le temps jusqu'à un résultat utilisable et le nombre de retours, en dit plus qu'un graphique de lancement, et la réponse tient tant que votre travail ne change pas.
Sources et méthode
Nous n'avons pas testé ces modèles nous-mêmes pour cet article. Chaque chiffre vient des pages ci-dessous, lues le 18 novembre 2026. Les lignes marquées « mesuré par OpenAI » sont les tests d'OpenAI sur ses propres modèles et sur Claude. Les lignes indépendantes sont celles d'Artificial Analysis, qui publie sa méthode. Les pages des éditeurs changent chaque semaine : vérifiez la page officielle avant d'acheter.
- Introducing GPT-6.2 Astra and Sol, OpenAI, 17 novembre 2026
- GPT-6.2 dans ChatGPT Work, Codex et l'API, ChatGPT Learn, 17 novembre 2026
- Fiche système de GPT-6.2, OpenAI Deployment Safety Hub, 17 novembre 2026
- Claude Fable 5.2 and Mythos 5.2, Anthropic, 9 novembre 2026
- OpenAI has the #2 model in the Intelligence Index with GPT-6.2 Astra and Sol, Artificial Analysis, 17 novembre 2026
- GPT-6.2 Astra vs Claude Fable 5.2 et GPT-6.2 Sol vs Claude Opus 5.5, comparatifs d'Artificial Analysis, lus le 18 novembre 2026
- "Essentially unusable": OpenAI launches GPT-6.2 Astra and Sol to negative reception from AI power users, Carl Franzen, VentureBeat, 17 novembre 2026
- We tested OpenAI's GPT-6.2 Astra for two weeks, Dan Shipper, Every, 17 novembre 2026
- Ethan Mollick sur GPT-6.2 Astra, X, 17 novembre 2026
- GPT-6.2 Astra vs Claude Fable 5.2: benchmarks, pricing and which is better, AlphaCorp AI, 17 novembre 2026
- GPT-6.2 Sol vs Claude Opus 5.5: benchmarks and cost, DataCamp, novembre 2026
- Tarifs de Claude, tarifs de ChatGPT, forfaits ChatGPT Pro et facturation de ChatGPT Business, lus le 18 novembre 2026
- Notes de version de Claude et journal des versions de ChatGPT et Codex, lus le 18 novembre 2026
- Gérer plugins, skills et connecteurs depuis une seule page, centre d'aide de Claude, et Skills and Plugins, ChatGPT Learn
- ChatGPT Record, centre d'aide d'OpenAI, et l'annonce du mode Record par OpenAI, X, 18 juin 2025
- Anthropic brings Claude to Google Meet to tackle tasks live, Reuters, 10 novembre 2026
- Claude or ChatGPT for Excel? Both have add-ins now, Chris Alarcon, mis à jour le 9 novembre 2026
- Introducing dots, OpenAI, 29 septembre 2026, et ChatGPT Space, OpenAI
- GPT-6, Wikipédia, pour la date de sortie de GPT-6 Astra
- Toni Dos Santos, Teach Them to Drive: The AI Adoption Playbook for Teams (en anglais)