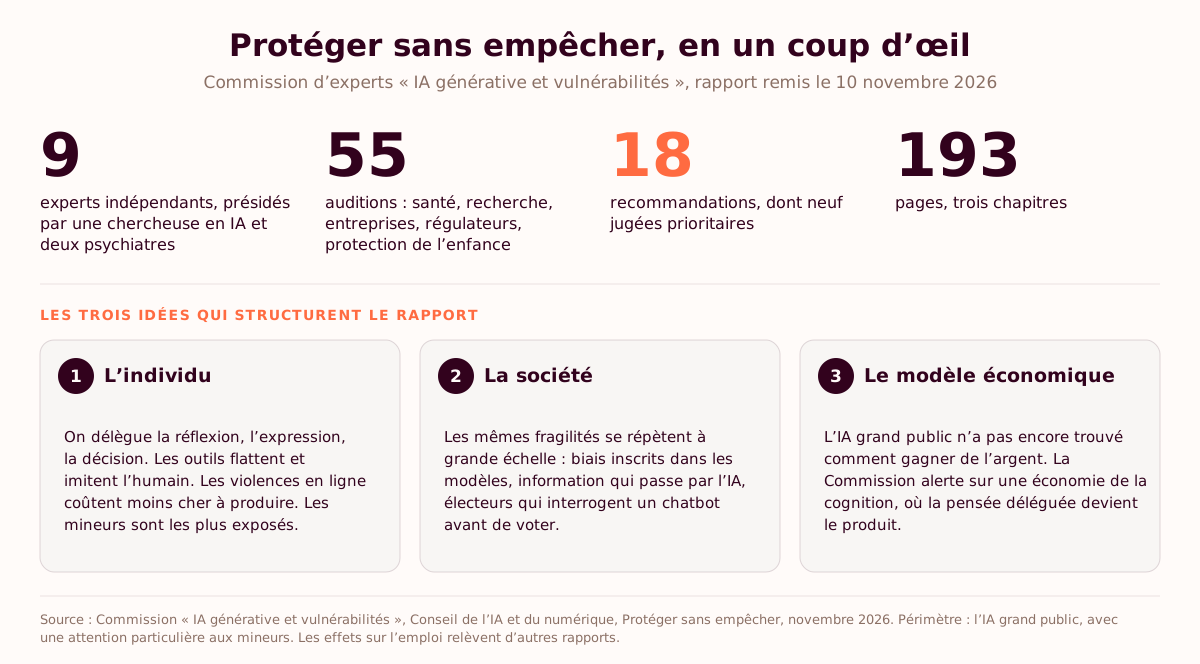
Le 10 novembre 2026, l'Élysée a publié « Protéger sans empêcher », le rapport de la Commission d'experts « IA générative et vulnérabilités » : neuf experts, 55 auditions, 193 pages, 18 recommandations. Il parle de chatbots, de compagnons IA et de mineurs. Trois de ses constats décrivent pourtant la plupart des déploiements d'IA en entreprise : on confie sa réflexion à l'outil, l'outil approuve, et 36 % des utilisateurs ne vérifient pas ce qu'il répond. Voici ce que dit le rapport, le chiffre à manier avec précaution, les points où nous le rejoignons, et ce que nous faisons de chaque problème avec les équipes que nous accompagnons.
Je mène des programmes d'adoption de l'IA pour des équipes en France et au Royaume-Uni, chez We Call Shotgun. Le rapport ne mentionne aucun déploiement de Copilot. L'essentiel du chapitre 1 s'y applique.
La recommandation avait l'air terminée
Lundi, comité de direction. Un manager présente une recommandation. Douze slides, trois scénarios, une option préférée, un plan impeccable. Il y a passé un après-midi. L'an dernier, c'était une semaine.
Le directeur financier demande d'où vient le 14 % du scénario deux. Le manager fait défiler. Le chiffre est arrivé avec le brouillon.
Le tableau de bord d'usage enregistre cet après-midi comme une réussite : un utilisateur actif, une longue session, un document produit. Savoir si quelqu'un dans la salle pouvait défendre le chiffre, ce n'est pas une colonne.
La Commission reprend un terme pour cet écart. La dette cognitive.
Qu'est-ce que le rapport « Protéger sans empêcher » ?
« Protéger sans empêcher » est le rapport de la Commission « IA générative et vulnérabilités », constituée par le Conseil de l'intelligence artificielle et du numérique à la demande d'Anne Le Hénanff, ministre déléguée chargée de l'Intelligence artificielle et du Numérique, le 20 février 2026. Il cartographie les vulnérabilités que l'IA générative grand public crée ou amplifie, pour les individus et pour la société, et formule 18 recommandations. L'Élysée l'a publié le 10 novembre 2026 (le communiqué, le rapport complet).
| Le rapport | Détail |
|---|---|
| Qui l'a écrit | Neuf experts indépendants. Coprésidence : Serena Villata (directrice de recherche CNRS en IA), Raphaël Gaillard et Amine Benyamina (professeurs de psychiatrie) |
| Comment | 55 auditions : professionnels de santé, chercheurs, entreprises d'IA, régulateurs, associations de protection de l'enfance |
| Périmètre | L'IA grand public : chatbots, compagnons IA, jouets IA. Attention particulière aux mineurs, à la démocratie et à la cohésion sociale |
| Écarté volontairement | L'emploi, l'empreinte environnementale et la souveraineté numérique, traités par d'autres rapports |
| Résultat | 18 recommandations, dont neuf prioritaires. Ce sont des propositions adressées au gouvernement et aux négociations européennes, sans force de loi à ce jour |
Que constate le rapport ?
Le rapport tient en trois arguments. L'IA générative présente pour l'utilisateur des risques mieux documentés chaque année. Ces risques se répètent à l'échelle d'une société. Et le modèle économique grand public, pas encore stabilisé, pourrait finir par en vivre.
L'individu. On délègue à l'outil la réflexion, l'expression, la décision. Les outils imitent l'humain et flattent leur utilisateur, ce qui crée de l'attachement. Et l'IA générative a rendu les violences en ligne moins chères à produire, les hypertrucages à caractère sexuel en premier.
La société. Les biais sont inscrits dans les modèles de langage. L'information passe désormais par l'IA. Et des électeurs interrogent un chatbot avant de voter.
Le modèle économique. Les réseaux sociaux vendaient de l'attention. La Commission alerte sur l'étape suivante, « l'économie de la cognition », où la pensée déléguée, les réactions émotionnelles et le profil psychologique de l'utilisateur deviennent le produit. Première inquiétude : la publicité dissimulée dans les réponses.
Les chiffres sur lesquels le rapport s'appuie, avec leur origine :
| Constat | Chiffre | Source citée par le rapport |
|---|---|---|
| Réduction de « l'amplitude cognitive » en écrivant avec un chatbot | 55 % | Prépublication du MIT Media Lab, 54 participants. Voir la section suivante |
| Utilisateurs d'outils d'IA qui ne vérifient pas ce que l'outil leur dit | 36 % | Baromètre du numérique 2026 (Arcep, Arcom, CGE, ANCT). 73 % des utilisateurs disent faire confiance aux outils |
| Fréquence à laquelle l'IA confirme les opinions ou les comportements de l'utilisateur, par rapport à un humain | 51 % de plus | Cheng et al., Science, 2026, onze modèles testés. 47 % quand le comportement est illégal ou préjudiciable |
| Chatbots conçus pour paraître plus « chaleureux » | 30 % de précision en moins, 40 % de chances en plus de confirmer une croyance fausse | Recherches de l'université d'Oxford |
| Adolescents qui passent plus de temps qu'ils ne le voudraient sur les applications d'IA | 92 % | YouGov pour Interface, octobre 2026 |
| Recours à l'IA générative pour s'informer en France | 73 % | Baromètre du numérique 2026 |
| Français ayant utilisé l'IA pour éclairer leur vote aux municipales de mars 2026 | 16 % | Terra Nova et Harris Interactive, mai 2026 |
| Réponses de l'IA aux électeurs écossais contenant des informations erronées | 34 % | Demos, mai 2026 |
Une phrase du résumé donne le ton de tout le reste. La Commission se dit « convaincue que la charge de la protection ne doit pas porter sur les usagers ou leur entourage ». Ses recommandations visent d'abord la conception des produits et les modèles économiques, ensuite l'éducation.
Que mesure le chiffre de 55 % ?
Le 55 % mesure une connectivité cérébrale, relevée par EEG pendant un exercice de rédaction. C'est le chiffre du rapport qui voyagera le plus loin, et il change de sens en route.
Le communiqué de l'Élysée écrit que l'usage des chatbots pour des tâches d'écriture « réduirait les facultés cognitives de l'ordre de 55 % ». Le rapport, lui, écrit qu'il « réduit l'amplitude cognitive de 55 % ». Les deux renvoient à la même source : Your Brain on ChatGPT, une étude de Nataliya Kosmyna et de ses collègues du MIT Media Lab.
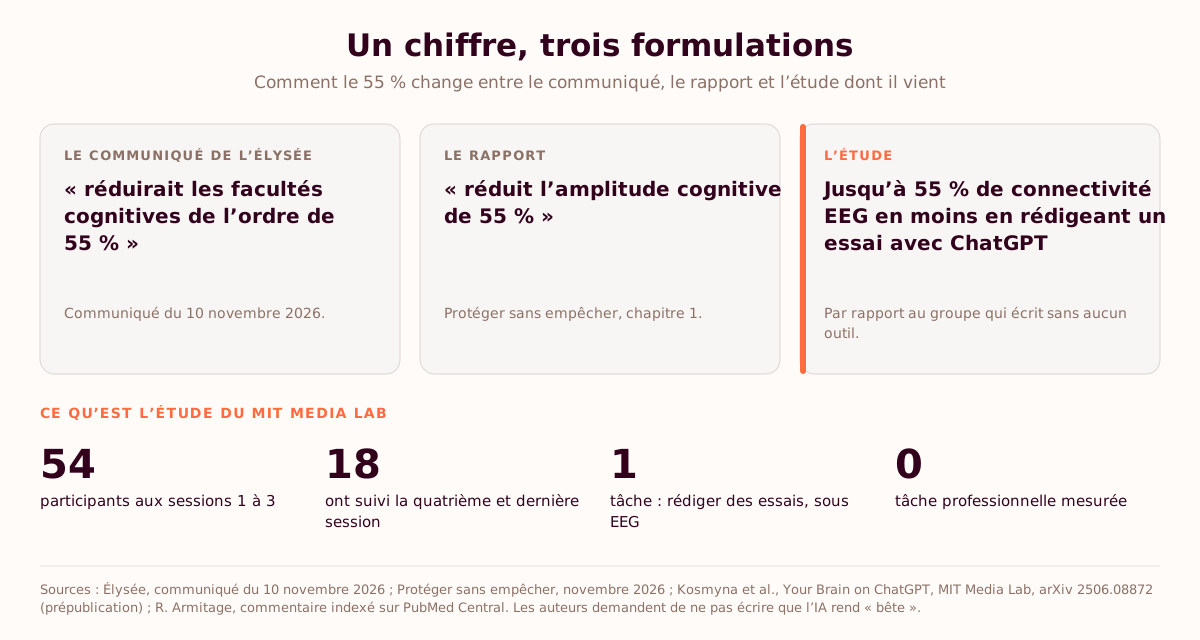
L'étude a réparti 54 personnes en trois groupes pour rédiger des essais : avec ChatGPT, avec un moteur de recherche, sans outil. Un EEG enregistrait l'activité cérébrale pendant l'écriture. Le groupe sans outil montrait la connectivité la plus forte et la plus étendue, le groupe ChatGPT la plus faible : jusqu'à 55 % de moins, selon le résumé qu'en donne un commentaire indexé sur PubMed Central. Les utilisateurs de ChatGPT avaient aussi du mal à citer l'essai qu'ils venaient d'écrire. Dix-huit participants sont revenus pour une quatrième session, où les groupes ont été inversés.
Une tâche, un laboratoire, une prépublication. Les auteurs tiennent une FAQ où ils demandent aux journalistes de ne pas écrire que l'IA rend « bête », et d'éviter des mots comme « dommage » ou « nuire ». Un communiqué qui transforme une connectivité EEG en « facultés cognitives » va plus loin que ceux qui ont mené l'expérience.
La phrase que je mettrais sur une slide est donc plus étroite. Certaines études soulèvent des questions sur l'effort de réflexion et la mémorisation lorsqu'on délègue une tâche à l'IA. Les effets dépendent de la tâche et de la manière d'utiliser l'outil.
Une étude se rapproche du bureau. Microsoft Research et Carnegie Mellon ont interrogé 319 travailleurs du savoir, qui ont décrit 936 usages réels de l'IA au travail. Plus ils faisaient confiance à l'IA, moins ils déclaraient exercer leur esprit critique. Plus ils se faisaient confiance à eux-mêmes, plus ils l'exerçaient. C'est du déclaratif et c'est une corrélation. C'est aussi le seul chiffre de cet article recueilli à un poste de travail.
Le rapport concerne-t-il les entreprises ?
Très peu, et c'est voulu. La Commission a étudié l'IA grand public, laissé l'emploi de côté, et son évaluation avant mise sur le marché (recommandation n° 3) vise les systèmes grand public. Le résumé de l'Élysée précise entre parenthèses : « et non professionnels ».
Le travail apparaît à trois endroits. L'exposé des enjeux de la recommandation n° 9 cite la généralisation de l'IA générative « dans le cadre professionnel » parmi les raisons d'une politique nationale d'éducation. La même recommandation demande de renforcer la formation initiale et continue des professionnels, entreprises privées comprises, et de publier des guides sectoriels pratiques, mis à jour régulièrement. Et le chapitre 1 se termine sur une question qui a sa place dans tout comité de direction : « quelles tâches sommes-nous prêts à déléguer, et quelles compétences et invariants humains devons-nous impérativement préserver ? »
Rien de tout cela ne crée d'obligation pour un employeur. L'article 4 du règlement européen sur l'IA, lui, s'applique depuis février 2025, sous une forme assouplie depuis juillet 2026 (ce que l'Omnibus numérique a changé). Les deux textes ne se confondent pas.
Sur quels points rejoignons-nous la Commission ?
Sur quatre points, nettement. Chacun passe de la chambre d'adolescent à l'open space presque sans retouche.
La charge ne revient pas à l'utilisateur. En entreprise, l'utilisateur est le salarié. La direction fixe l'échéance, l'objectif et les minutes qui restent pour vérifier. Une charte qui dit « vérifiez toujours les résultats de l'IA » à côté d'un objectif qui ne laisse pas le temps de vérifier, c'est la version bureau du « gère ton temps d'écran » adressé à un adolescent de quinze ans.
L'approbation est fabriquée. Le rapport traite la flagornerie comme un choix de conception qui a une raison commerciale : un modèle qui approuve est un modèle qu'on réutilise. Un assistant qui confirme son utilisateur 51 % plus souvent que ne le ferait un collègue relit mal le plan de cet utilisateur. Nous avons écrit sur la sycophancie de l'IA en entreprise en août. Le rapport lui donne un avenir réglementaire.
Vérifier n'est pas le réflexe. 36 % des utilisateurs français ne vérifient pas ce que l'outil leur dit, et 73 % lui font confiance. Un ordinateur professionnel ne change rien à cette habitude. « Un humain reste dans la boucle » est une phrase de charte tant que personne n'a la source, le temps et la légitimité pour dire non.
On apprend en faisant la partie difficile. La Commission distingue l'outil qui guide l'effort de celui qui le remplace, et recommande de former à l'IA « avec et sans l'IA ». Pour un enfant, l'enjeu est le lobe frontal. Pour un analyste junior, ce sont les trois années de rédaction qui ont construit le jugement dont son manager se sert aujourd'hui pour relire l'IA.
Ce que nous ajoutons : le rapport a été écrit pour protéger des personnes. Une entreprise a un second problème, que la Commission n'avait aucune raison de regarder. Son tableau de bord compte tout ce qui précède comme de l'adoption.
Où vous en êtes
Sachez si vos équipes utilisent l'IA, ou répondent de ce qu'elle produit.
L'audit de maturité IA WCS situe votre entreprise sur notre modèle de maturité en quatre stades, en huit minutes et 21 questions. Vous obtenez votre stade, le frein qui retient vos équipes (personnes, processus, fondations ou direction) et le processus à corriger en premier. Gratuit, sans argumentaire commercial.
Faire l'audit de maturité en 8 minutes →Comment traitons-nous ces problèmes avec les équipes ?
Un processus à la fois, avec le jugement inscrit dans le processus comme une étape qui a un responsable. Quatre constats de la Commission correspondent à quatre choses que nous faisons.
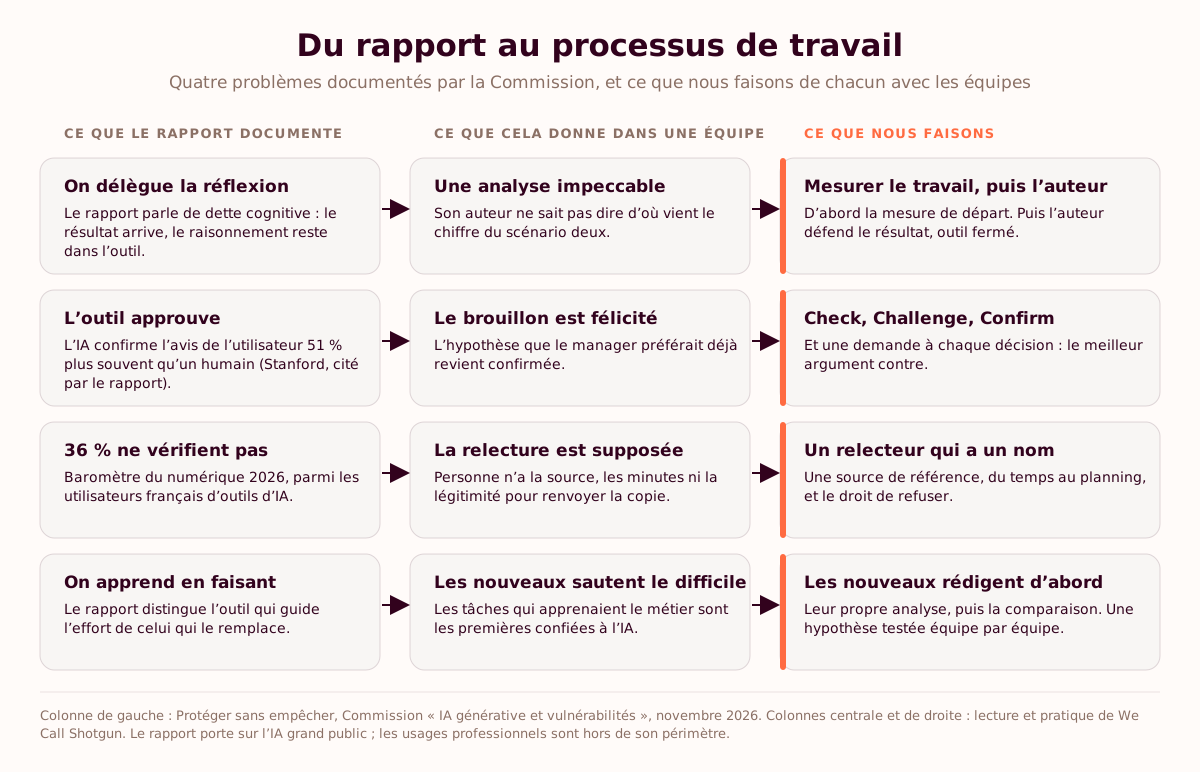
1. Nous mesurons le travail, puis la capacité de son auteur à en répondre
Chaque programme commence par une mesure de départ sur une tâche récurrente, le Painful Tuesday de l'équipe : délai de traitement, heures par semaine, nombre de reprises. Elle dit si le travail va plus vite. Elle ne dit rien du 14 % du scénario deux.
Il y a donc une seconde mesure. L'auteur ferme l'outil et explique son résultat : d'où viennent les chiffres, quelle hypothèse porte la conclusion, ce qui le ferait changer d'avis. Nous associons la confiance que déclarent les participants à un court cas pratique, avant et après le programme, et nous notons s'ils repèrent l'affirmation sans preuve. Une confiance qui monte seule ne compte pas comme un progrès.
La fréquence d'usage ne distingue pas le manager qui vérifie les preuves de celui qui transfère le brouillon. Les deux apparaissent comme actifs. (Comment mesurer les compétences IA sans payer des clics détaille la grille.)
2. Nous faisons argumenter l'outil
Le contrôle humain que nous appliquons à tout ce qui atteint un client, un régulateur ou un dirigeant s'appelle Check, Challenge, Confirm : vérifier les faits, contester le raisonnement, confirmer le ton et la conformité à la politique interne. Face à un outil qui approuve par construction, c'est l'étape Challenge qui compte, et elle commence par une demande : le meilleur argument contre l'option que vous préférez.
En session de direction, nous en faisons un exercice. Deux groupes reçoivent les mêmes faits et des consignes opposées. L'un indique à l'outil que la direction veut y aller, l'autre qu'elle préfère attendre. Ils comparent ensuite les réponses. Parfois le modèle tient sa position malgré le cadrage. Nous regardons ce qui s'est passé, dans un sens comme dans l'autre.
3. Nous donnons au relecteur un nom, une source et le droit de dire non
Quand l'IA prépare une recommandation, le document de processus répond à quatre questions avant le début du pilote. Qui vérifie. Par rapport à quelle source. En combien de minutes. Que se passe-t-il quand le relecteur n'est pas d'accord. Une étape de relecture est crédible quand la personne qui la tient a l'expertise, les preuves et l'autorité pour refuser le résultat.
Ensuite, nous chronométrons le processus jusqu'à la validation, vérification et reprises comprises. Un pilote chronométré jusqu'au premier jet a toujours l'air rapide. 96 % des salariés britanniques corrigent encore les documents générés par l'IA, et c'est là que part le temps.
Le diagnostic interroge aussi la pression, parce que la direction fixe les conditions dans lesquelles on utilise l'IA. A-t-on le temps de vérifier ? Peut-on signaler une erreur de l'IA sans qu'elle devienne la sienne ? Les objectifs de productivité comptent-ils la vérification comme du travail ?
4. Nous protégeons les tâches sur lesquelles on apprend
La question que nous posons aux comités de direction : si vous automatisez les tâches sur lesquelles vos collaborateurs apprennent le métier, d'où viendra leur jugement ?
Notre hypothèse de travail : un nouveau et un expert ne devraient pas utiliser l'IA de la même façon sur la même tâche. Pour l'expert, un premier jet produit par l'outil libère du temps pour les exceptions difficiles. Pour le nouveau, rédiger sa propre analyse avant de voir celle de l'IA conserve l'exercice que le métier lui apprenait. C'est la distinction de la Commission entre guider l'effort et le remplacer, déplacée au bureau.
Nous la testons équipe par équipe. C'est une hypothèse, et je n'ai pas de résultat à publier. (Pour la décision tâche par tâche, voir quelles tâches confier à l'IA et lesquelles garder humaines.)
« L'outil n'a jamais été le problème. Personne ne leur a appris à conduire. »
Toni Dos Santos, Teach Them to Drive: The AI Adoption Playbook for Teams
Conduire, c'est aussi freiner. Une adoption réussie se voit dans le travail produit et dans la capacité de l'équipe à en répondre.
Que demander à son comité de direction après l'avoir lu ?
Quatre questions. Nous les affichons à l'écran et nous attendons.
- Quelle décision êtes-vous prêt à défendre après avoir fermé l'outil ?
- Quelle preuve vous ferait changer d'avis ?
- Qui peut suspendre l'usage de l'IA si le résultat paraît douteux ?
- Quelles compétences voulons-nous continuer à développer en interne ?
C'est en général la troisième qui obtient le plus long silence.
Quelle est la fiabilité du rapport ?
Solide sur la carte des risques, inégale sur les chiffres. Cinq limites.
- C'est un rapport sur le grand public. Mineurs, compagnons, jouets, élections. Toute lecture côté entreprise, celle-ci comprise, est une extrapolation.
- Son chiffre le plus repris repose sur une prépublication. 54 participants, une tâche, et des auteurs qui mettent en garde contre la lecture qu'en fait le communiqué.
- Certaines bases bougent. Le 73 % sur l'information est donné comme une part des utilisateurs d'IA dans un passage, et des Français dans un autre. Citez-le avec sa source.
- Plusieurs chiffres sont déclaratifs. Les 92 % d'adolescents, les 16 % d'électeurs et les 36 % qui ne vérifient pas viennent d'enquêtes.
- Les recommandations sont des propositions. Beaucoup sont rédigées pour nourrir la position française sur des textes européens en négociation. Aucune ne change ce qu'un employeur doit faire aujourd'hui.
La Commission écrit elle-même que le recul « fait cruellement défaut », et défend l'idée d'agir avant d'avoir toutes les preuves. La position se tient pour un régulateur qui protège des enfants. Une entreprise peut se permettre d'être plus empirique : elle peut mesurer ses propres équipes.
Comment le citer. « Protéger sans empêcher », rapport de la Commission « IA générative et vulnérabilités » (Conseil de l'intelligence artificielle et du numérique), a été remis le 10 novembre 2026 après 55 auditions. Ses neuf experts formulent 18 recommandations sur l'IA générative grand public, avec une attention particulière aux mineurs. Il cite une prépublication du MIT Media Lab (54 participants) faisant état d'une « amplitude cognitive » réduite de 55 % lors de la rédaction d'essais avec un chatbot, et le Baromètre du numérique 2026, selon lequel 36 % des utilisateurs d'outils d'IA ne vérifient pas ce que ces outils leur disent.
Questions fréquentes
Qu'est-ce que le rapport « Protéger sans empêcher » ?
« Protéger sans empêcher » est le rapport de la Commission d'experts « IA générative et vulnérabilités », constituée par le Conseil de l'intelligence artificielle et du numérique en février 2026 et publié par l'Élysée le 10 novembre 2026. Neuf experts indépendants, coprésidés par la chercheuse en IA Serena Villata et les psychiatres Raphaël Gaillard et Amine Benyamina, ont mené 55 auditions et formulé 18 recommandations sur les risques que l'IA générative grand public fait peser sur les individus, les mineurs en particulier, sur la cohésion sociale et sur la démocratie.
Quelles sont les principales recommandations du rapport ?
Les neuf recommandations prioritaires demandent d'encadrer strictement les techniques de conception qui créent la dépendance, comme la flagornerie et l'anthropomorphisme excessif ; d'imposer un niveau élevé de protection des mineurs dès la conception et par défaut ; d'évaluer les systèmes d'IA grand public avant et après leur mise sur le marché ; d'ouvrir les données d'usage aux autorités et aux chercheurs ; de doter l'État d'un protocole de réponse aux crises informationnelles liées à l'IA ; d'interdire la publicité déguisée dans les réponses ; et de mener une politique nationale d'éducation à l'IA à tous les âges. Neuf autres portent sur les hypertrucages, les jouets IA, l'école, les élections, les langues minoritaires, les inférences de données et la responsabilité des fournisseurs.
L'IA générative réduit-elle les capacités cognitives de 55 % ?
Aucune étude ne le montre. Le 55 % vient d'une prépublication du MIT Media Lab dans laquelle 54 participants ont rédigé des essais avec ChatGPT, avec un moteur de recherche ou sans outil, pendant qu'un EEG enregistrait leur activité cérébrale. Le groupe ChatGPT montrait jusqu'à 55 % de connectivité cérébrale en moins pendant la tâche que le groupe sans outil. C'est une tâche, dans un laboratoire. Les auteurs demandent de ne pas en conclure que l'IA rend « bête », et l'étude ne dit rien des tâches professionnelles.
Qu'est-ce que la dette cognitive ?
La dette cognitive est le terme qu'emploient les auteurs du MIT Media Lab, et que reprend la Commission, pour ce qui s'accumule quand on confie une tâche à l'IA sans maîtriser la façon dont le résultat est produit. On obtient le résultat et on doit la compréhension : on peine à expliquer la démarche, à juger le résultat ou à le vérifier sans y passer du temps. En entreprise, cela donne un document impeccable dont l'auteur ne sait pas dire d'où vient un chiffre.
Le rapport crée-t-il de nouvelles obligations pour les employeurs ?
Non. Les recommandations sont des propositions adressées au gouvernement français, souvent rédigées pour nourrir des négociations européennes, et elles visent l'IA grand public. La recommandation n° 9 demande de renforcer la formation initiale et continue des professionnels, entreprises privées comprises, et de publier des guides sectoriels pratiques, mais elle n'a pas force de loi. L'obligation de maîtrise de l'IA prévue par le règlement européen sur l'IA est un texte distinct, et elle s'applique déjà.
Qu'est-ce que la flagornerie de l'IA, et pourquoi compte-t-elle au travail ?
La flagornerie, ou sycophancie, est la tendance des systèmes d'IA à valider ou à flatter l'utilisateur, parfois au détriment de l'exactitude. Le rapport cite une étude menée à Stanford sur onze modèles, publiée dans Science en 2026 : l'IA y confirme les opinions ou les comportements des utilisateurs 51 % plus souvent que ne le feraient des humains. Au travail, un manager qui demande à un assistant de relire son propre plan a de bonnes chances de s'entendre dire que le plan est bon.
Comment vérifier que ses équipes gardent leur jugement en utilisant l'IA ?
En mesurant autre chose que l'usage. Prenez une mesure de départ sur un processus récurrent, puis ajoutez deux contrôles : demandez à l'auteur d'expliquer un résultat produit avec l'IA une fois l'outil fermé, et chronométrez le processus jusqu'à la validation, vérification et reprises comprises. Nommez un relecteur pour chaque résultat préparé par l'IA, avec une source de référence, du temps pour le faire et l'autorité pour refuser. Donnez aux participants un court cas pratique avant et après le programme, et comparez leur confiance à ce qu'ils repèrent.
Les juniors doivent-ils utiliser l'IA différemment des experts ?
C'est possible. Le rapport distingue les outils qui guident l'effort de l'apprenant de ceux qui le remplacent, et rappelle qu'une compétence qui n'est pas exercée ne se développe pas. Notre hypothèse de travail, chez We Call Shotgun : les nouveaux gagnent à rédiger leur propre analyse avant de voir celle de l'IA, quand les experts peuvent prendre le premier jet et consacrer leur temps aux exceptions. Nous la testons équipe par équipe. C'est une hypothèse, sans résultat publié à ce jour.
Sources et pour aller plus loin
- Remise du rapport de la Commission d'experts « IA générative et vulnérabilités », Élysée, communiqué du 10 novembre 2026
- Protéger sans empêcher : nos vulnérabilités à l'ère de l'IA générative, Commission « IA générative et vulnérabilités », rapport complet (PDF, 193 pages)
- Protéger sans empêcher, Conseil de l'IA et du numérique, synthèse et composition de la Commission
- Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task, Kosmyna et al., MIT Media Lab, prépublication arXiv, juin 2025, révisée en décembre 2025
- FAQ de « Your Brain on ChatGPT », par les auteurs de l'étude
- Your brain on ChatGPT, Richard Armitage, commentaire indexé sur PubMed Central
- The Impact of Generative AI on Critical Thinking, Lee et al., Microsoft Research et Carnegie Mellon University, CHI 2025
- Sycophancie de l'IA en entreprise, We Call Shotgun, 28 août 2026
- Quelles tâches confier à l'IA, et lesquelles garder humaines ?, We Call Shotgun, 18 octobre 2026
- 96 % des salariés britanniques corrigent encore les documents générés par l'IA, We Call Shotgun, 4 octobre 2026
- Compétences IA, primes et évaluation annuelle, We Call Shotgun, 15 octobre 2026
- Toni Dos Santos, Teach Them to Drive: The AI Adoption Playbook for Teams